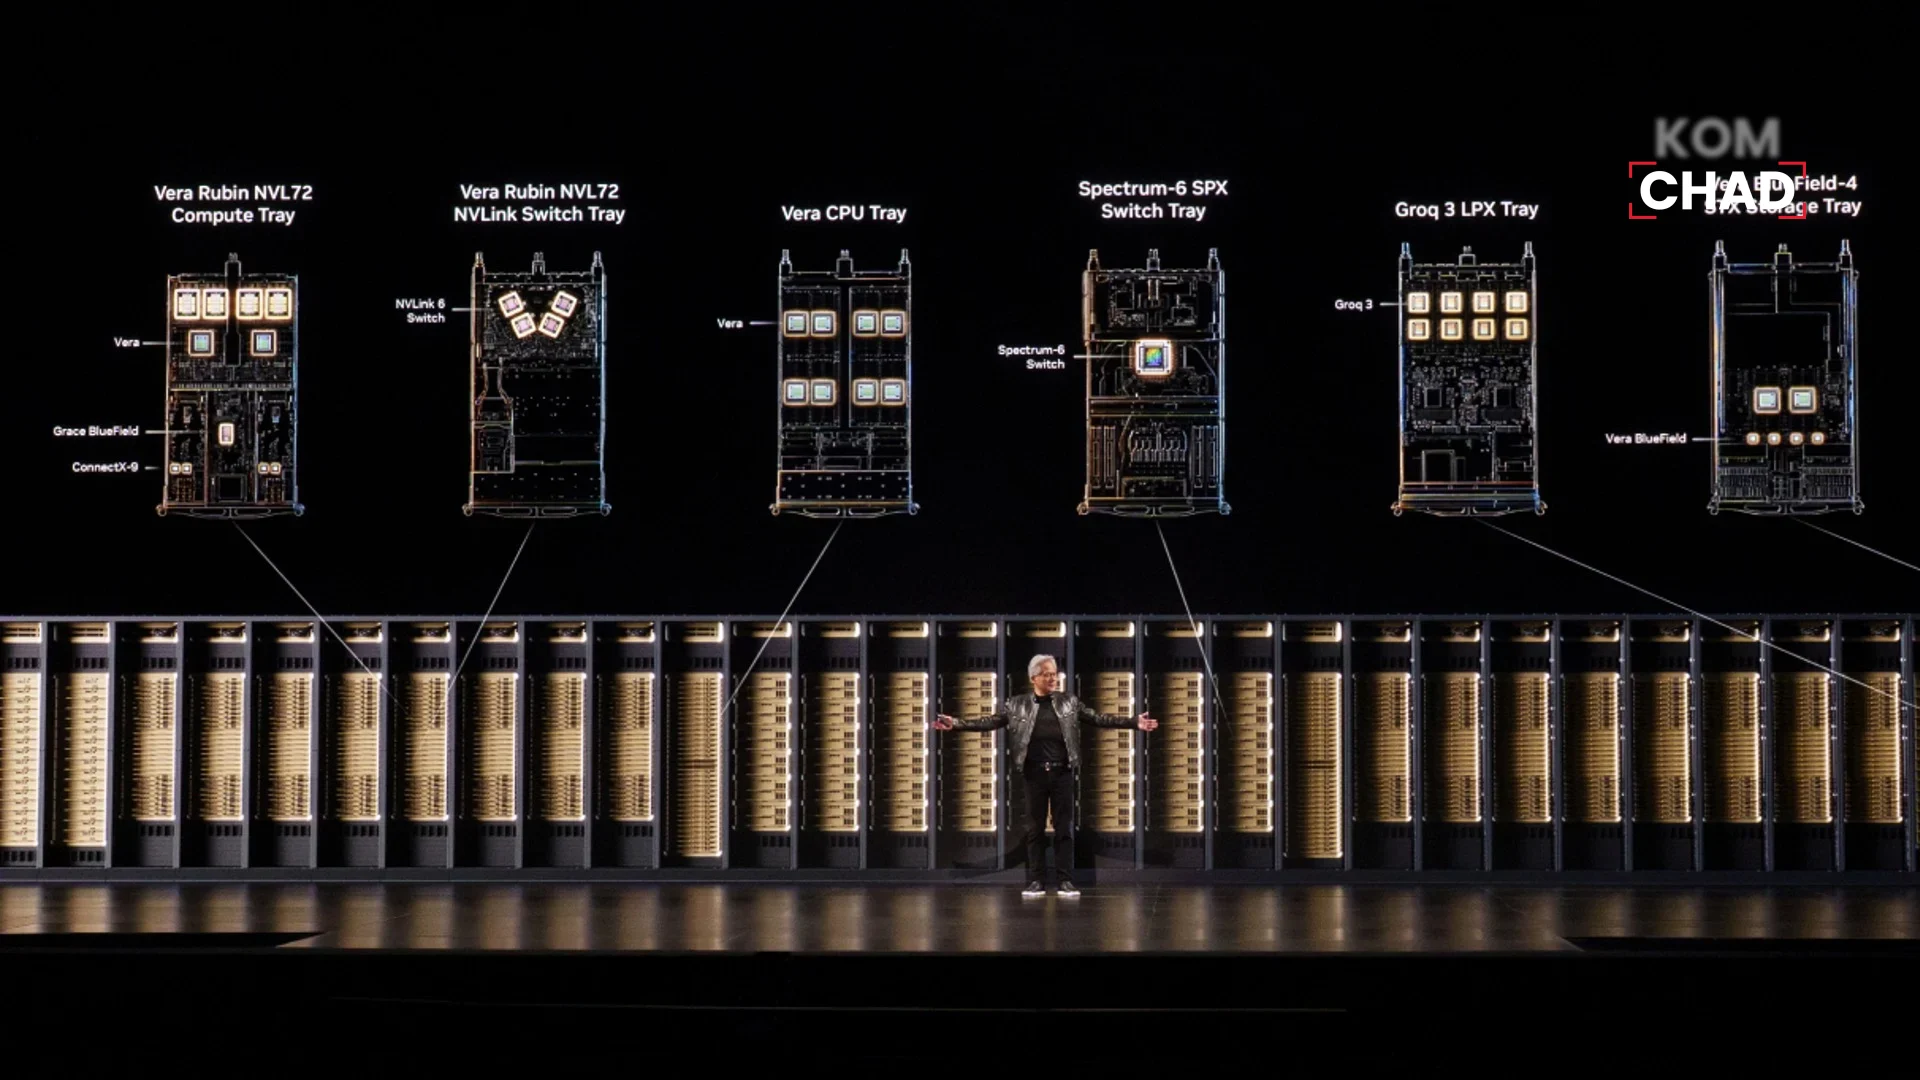
NVIDIA เผยแพร่บทความ “More Performance From Every Byte” เมื่อ 5 พฤศจิกายน 2569 อธิบายแนวทางรับมือปัญหาหน่วยความจำ AI ที่ทั้งขาดตลาดและราคาแพงขึ้น ใจความหลักคือการเพิ่ม HBM บนการ์ดจออย่างเดียวไม่พอ แต่ต้องออกแบบร่วมกันทั้งระบบ ตั้งแต่ GPU, CPU, เครือข่าย, สตอเรจ ไปจนถึงซอฟต์แวร์ NVIDIA อ้างว่า Vera Rubin NVL72 ให้ปริมาณงานต่อดอลลาร์สูงกว่า GB300 NVL72 สูงสุด 30 เท่า ทั้งที่ HBM ต่อ GPU เพิ่มขึ้นเพียงราว 3%
สารบัญ
⚡ สรุปข่าวใน 30 วินาที
- บทความ NVIDIA วันที่ 5 พ.ย. 2569 ว่าด้วยปัญหาหน่วยความจำของงาน AI
- โมเดลใหญ่ขึ้น บริบทยาวขึ้น และงานเอเจนต์ทำให้ HBM ไม่พอ ขณะที่ราคาหน่วยความจำสูงขึ้น
- ใช้ NVFP4 ลดขนาดน้ำหนักโมเดลและ KV cache
- Dynamo กับ CMX ย้าย KV cache ที่ไม่ได้ใช้ออกจาก HBM
- Vera Rubin NVL72 คุ้มกว่า GB300 NVL72 สูงสุด 30 เท่าต่อดอลลาร์
ปัญหาหน่วยความจำของ AI คืออะไร
งาน AI ยุคใหม่กินหน่วยความจำหนักขึ้นจาก 3 ทาง คือโมเดลใหญ่ขึ้น บริบทยาวขึ้น และงานแบบเอเจนต์ที่ต้องจำบทสนทนาและผลลัพธ์จากเครื่องมือจำนวนมาก NVIDIA ระบุว่าบางงานเอเจนต์มีบริบทสะสมถึง 3 ล้านโทเคน ข้อมูลส่วนนี้อยู่ใน KV cache ซึ่งต้องแย่งพื้นที่ HBM กับน้ำหนักของโมเดล
HBM คือหน่วยความจำที่เร็วที่สุดและถูกแย่งใช้มากที่สุดในระบบ แต่การใส่ HBM เพิ่มอย่างเดียวจะชนสิ่งที่ NVIDIA เรียกว่ากำแพงหน่วยความจำ แบนด์วิดท์ส่งข้อมูลให้หน่วยประมวลผลไม่ทัน ความจุที่เพิ่มจึงใช้ไม่เต็มที่ แต่ยังเพิ่มทั้งต้นทุนและการใช้ไฟ ปัญหานี้หนักขึ้นเพราะตลาดหน่วยความจำตึงตัวและราคาสูงขึ้นทั่วโลก
แนวทางออกแบบทั้งระบบของ NVIDIA
แทนที่จะเพิ่มหน่วยความจำบน GPU อย่างเดียว NVIDIA ใช้หลายเทคโนโลยีทำงานร่วมกัน เพื่อให้ HBM ทุกไบต์ถูกใช้กับงานที่สำคัญที่สุด
| เทคโนโลยี | ช่วยอะไร |
|---|---|
| NVFP4 | รูปแบบตัวเลข 4 บิต ลดขนาดน้ำหนักโมเดลและ KV cache เทียบกับ FP8 |
| NVL72 | กระจายน้ำหนักโมเดลไปบน GPU สูงสุด 72 ตัว เหลือ HBM ให้ KV cache มากขึ้น |
| Vera CPU + NVLink-C2C | หน่วยความจำ LPDDR ของ Vera เชื่อมกับ Rubin GPU เป็นที่พักบริบทที่หยุดชั่วคราว |
| NVIDIA Dynamo | ย้าย KV cache ที่ไม่ได้ใช้ไปเก็บที่อื่น และจัดการ KV cache เป็นทรัพยากรเดียวทั้งระบบ |
| NVIDIA CMX | ชั้นสตอเรจสำหรับบริบทแบบใช้ร่วมกัน ต้นทุนต่อบิตต่ำกว่า HBM |
| Nemotron Retriever + cuVS | ทำ embedding สำหรับ RAG ให้เล็กลง และเก็บดัชนีไว้นอก HBM |
พาร์ตเนอร์ที่รองรับ CMX มีทั้ง Cloudian, DDN, Dell, Everpure, HPE, IBM, NetApp, VAST และ WEKA
ตัวเลขประสิทธิภาพที่ NVIDIA อ้าง
NVIDIA ใช้ผลทดสอบ SemiAnalysis AgentX เทียบระบบแต่ละรุ่น จุดที่น่าสนใจคือการเพิ่มประสิทธิภาพส่วนใหญ่ไม่ได้มาจากความจุ HBM ที่เพิ่มขึ้น
| การเทียบ | ปริมาณงานต่อดอลลาร์ | HBM ต่อ GPU |
|---|---|---|
| GB300 NVL72 vs H200 (100 โทเคน/วินาที/ผู้ใช้) | สูงสุด 10 เท่า | เพิ่มราว 2 เท่า |
| Vera Rubin NVL72 vs GB300 NVL72 (125 โทเคน/วินาที/ผู้ใช้) | สูงสุด 30 เท่า | เพิ่มราว 3% |
ตัวเลขนี้แสดงว่าในรุ่น Vera Rubin ประสิทธิภาพที่เพิ่มมาจากการออกแบบระบบโดยรวม ไม่ใช่จากหน่วยความจำที่มากขึ้น ซึ่งสำคัญมากในช่วงที่ HBM และ DRAM ขาดตลาด
ตัวเลขเป็นผลทดสอบที่ NVIDIA อ้างอิง ผลจริงขึ้นกับรุ่นโมเดล ขนาดบริบท และรูปแบบงานของแต่ละองค์กร
โมเดลที่รองรับ NVFP4 แล้ว
NVIDIA ระบุว่ามีหลายโมเดลปล่อยน้ำหนักแบบ NVFP4 แล้ว เช่น FLUX.2 [klein], Inkling, Beam 1.0, Meta Muse Spark, Step 5 Preview และ Nemotron 3.5 Super VL การมีโมเดลรองรับ NVFP4 มากขึ้นทำให้ผู้ให้บริการรันโมเดลขนาดใหญ่บน HBM เท่าเดิมได้มากขึ้น
สำหรับผู้ใช้ทั่วไป ผลที่จะเห็นคือบริการ AI รองรับบริบทยาวขึ้นและตอบเร็วขึ้นโดยราคาไม่ต้องขึ้นตามราคาหน่วยความจำ ส่วนธุรกิจที่ลงทุนระบบ AI เอง บทความนี้ชี้ว่าควรดูประสิทธิภาพทั้งระบบ ไม่ใช่แค่ความจุหน่วยความจำของ GPU
- รุ่น H200 HBM3e ยุคแรก
- GB300 NVL72 HBM ต่อ GPU ราว 2 เท่าของ H200
- Vera Rubin NVL72 HBM4 เพิ่มราว 3% แต่ปริมาณงานต่อดอลลาร์เพิ่มสูงสุด 30 เท่า
- 5 พ.ย. 2569 NVIDIA เผยแพร่บทความอธิบายแนวทาง full-stack codesign
คำถามที่พบบ่อยเกี่ยวกับ ปัญหาหน่วยความจำ AI
ทำไม AI ใช้หน่วยความจำมากขึ้น
เพราะโมเดลใหญ่ขึ้น บริบทยาวขึ้น และงานเอเจนต์ต้องเก็บ KV cache จำนวนมาก
KV cache คืออะไร
ข้อมูลบริบทที่โมเดลเก็บไว้ระหว่างตอบ ยิ่งบทสนทนายาว KV cache ยิ่งใหญ่
NVFP4 ช่วยอะไร
เป็นรูปแบบตัวเลข 4 บิตที่ลดขนาดน้ำหนักโมเดลและ KV cache เทียบกับ FP8
Vera Rubin ดีกว่า GB300 แค่ไหน
NVIDIA อ้างว่าปริมาณงานต่อดอลลาร์สูงกว่าสูงสุด 30 เท่า
ผู้ใช้ทั่วไปได้อะไร
บริการ AI มีแนวโน้มรองรับบริบทยาวขึ้นและตอบเร็วขึ้นโดยไม่ต้องขึ้นราคาตามหน่วยความจำ
ความคิดเห็น 0
ยังไม่มีความคิดเห็นเป็นคนแรกที่แสดงความคิดเห็นในบทความนี้