Baidu ปล่อย ERNIE 5.5 Flash Base เมื่อ 5 พฤศจิกายน 2569 เป็นโมเดลภาษาแบบ Mixture-of-Experts ที่เปิดให้ดาวน์โหลดน้ำหนักได้ ขนาดรวม 280,000 ล้านพารามิเตอร์ แต่ใช้งานจริงเพียง 14,000 ล้านพารามิเตอร์ต่อโทเคน ฝึกจากศูนย์ด้วยข้อมูล 33.5 ล้านล้านโทเคน และรองรับบริบทยาวสูงสุด 1 ล้านโทเคนเมื่อปรับแต่งและใช้งาน จุดที่ต่างจากการปล่อยโมเดลทั่วไปคือ Baidu ปล่อยน้ำหนักตั้งแต่จบการฝึกขั้นแรก ยังไม่ผ่านการฝึกต่อหรือปรับให้คุยเป็น เพื่อให้นักพัฒนานำไปฝึกต่อเอง
สารบัญ
⚡ สรุปข่าวใน 30 วินาที
- ปล่อย 5 พ.ย. 2569 ดาวน์โหลดได้บน Hugging Face ทั้ง FP8 และ BF16
- MoE 280B พารามิเตอร์ ใช้งาน 14B ต่อโทเคน 512 experts
- ฝึก 33.5 ล้านล้านโทเคน ด้วย Muon optimizer และ FP8
- บริบทฝึก 128K ปรับแต่งและใช้งานได้ถึง 1M โทเคน
- เป็นโมเดลฐาน ยังไม่ผ่าน post-training Baidu บอกว่ารุ่นที่ฝึกต่อจะตามมา
สเปกของ ERNIE 5.5 Flash Base
โมเดลนี้ใช้สถาปัตยกรรม MoE แบบเบาบาง แต่ละชั้นมีผู้เชี่ยวชาญย่อย 512 ตัว เลือกใช้ 10 ตัวต่อโทเคน และมีผู้เชี่ยวชาญที่ใช้ร่วมกันอีก 1 ตัว ทำให้ความจุความรู้สูงแต่ค่าคำนวณต่อโทเคนใกล้เคียงโมเดลขนาด 14B
| หัวข้อ | ERNIE 5.5 Flash Base |
|---|---|
| ประเภท | Sparse Mixture-of-Experts (โมเดลฐาน) |
| พารามิเตอร์รวม / ใช้งาน | 280B / 14B ต่อโทเคน |
| ชั้น Transformer | 43 ชั้น, hidden size 4096, 64 attention heads |
| Experts | 512 routed (เลือก 10) + 1 shared ต่อชั้น MoE |
| ข้อมูลฝึก | 33.5 ล้านล้านโทเคน |
| การฝึก | Muon optimizer, FP8 mixed precision |
| บริบท | ฝึก 128K, ปรับแต่ง/ใช้งานได้ถึง 1M |
| สัญญาอนุญาต | ERNIE 5.5 Flash Base Model License Agreement v1.0 |
| ดาวน์โหลด | Hugging Face: baidu/ERNIE-5.5-Flash-Base (FP8), -BF16 |
ทำไมปล่อยเป็นโมเดลฐาน
Baidu ระบุว่าน้ำหนักชุดนี้เก็บตอนจบการฝึกขั้นแรก ไม่ผ่านขั้น mid-training หรือ post-training เป้าหมายคือให้เป็นจุดเริ่มต้นสำหรับการฝึกต่อ เช่น ปรับให้เชี่ยวชาญเฉพาะด้าน สอนให้ทำตามคำสั่ง ฝึกการให้เหตุผล ฝึกเป็นเอเจนต์ หรือใช้วิจัยการเรียนรู้แบบเสริมกำลัง
ข้อดีคือนักวิจัยได้โมเดลที่ยังไม่ถูกปรับพฤติกรรมไปทางใดทางหนึ่ง ตรวจสอบผลของการฝึกต่อได้ชัดกว่า ส่วนผู้ใช้ทั่วไปควรรู้ว่าโมเดลนี้ไม่ได้ออกแบบมาให้แชตโต้ตอบเหมือนผู้ช่วย AI Baidu ระบุว่ารุ่นที่ผ่านการฝึกต่อจะปล่อยตามมา
การเรียกใช้ผ่าน Transformers ต้องใส่ BOS token หรือตั้ง add_special_tokens=True ตามที่ Baidu แนะนำ ส่วนการรันจริงรองรับ SGLang และ vLLM ผ่าน completions API
ผลทดสอบเทียบโมเดลฐานอื่น
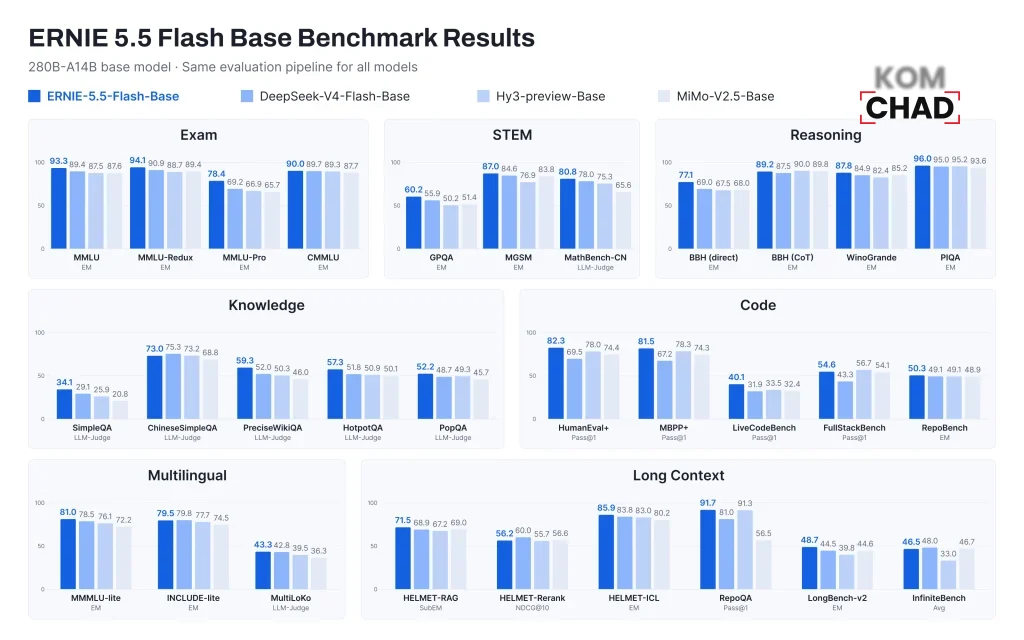
Baidu เทียบ ERNIE 5.5 Flash Base กับ DeepSeek V4 Flash Base, Hy3 preview Base และ MiMo V2.5 Base ใน 30 ชุดทดสอบ 7 หมวด ERNIE ทำคะแนนนำหลายรายการ โดยเฉพาะการให้เหตุผล การเขียนโค้ด และข้อสอบความรู้
| ชุดทดสอบ | ERNIE 5.5 Flash Base | หมายเหตุ |
|---|---|---|
| MMLU (5-shot) | 93.3 | สูงสุดในกลุ่ม |
| MMLU-Pro (5-shot) | 78.4 | อันดับสองได้ 69.2 |
| GPQA (5-shot) | 60.2 | สูงสุดในกลุ่ม |
| HumanEval+ (1-shot) | 82.3 | สูงสุดในกลุ่ม |
| LiveCodeBench (1-shot) | 40.1 | สูงสุดในกลุ่ม |
| LongBench-v2 (0-shot) | 48.7 | สูงสุดในกลุ่ม |
| ChineseSimpleQA | 73.0 | DeepSeek V4 Flash Base ได้ 75.3 |
| InfiniteBench | 46.5 | DeepSeek V4 Flash Base ได้ 48.0 |
รายการที่ ERNIE ยังตามหลังอยู่บ้างคือความรู้ภาษาจีนแบบถามตอบสั้นและงานบริบทยาวบางชุด ซึ่ง DeepSeek V4 Flash Base ทำได้ดีกว่าเล็กน้อย
ความหมายต่อวงการโมเดลเปิด
การปล่อยโมเดลฐานขนาดใหญ่แบบเปิดน้ำหนักทำให้บริษัทและสถาบันวิจัยมีตัวเลือกเพิ่มขึ้น โดยเฉพาะกลุ่มที่ต้องการฝึกโมเดลเฉพาะทางเองแต่ไม่มีงบฝึกจากศูนย์ การที่ใช้งานจริงเพียง 14B ต่อโทเคนยังช่วยลดต้นทุนการรันเมื่อเทียบกับโมเดลหนาแน่นขนาดเท่ากัน
อย่างไรก็ตาม ผู้ที่จะนำไปใช้เชิงพาณิชย์ควรอ่านสัญญาอนุญาต ERNIE 5.5 Flash Base Model License Agreement ให้ครบ เพราะเป็นสัญญาเฉพาะของ Baidu ไม่ใช่สัญญาโอเพนซอร์สมาตรฐาน
- 5 พ.ย. 2569 ปล่อย ERNIE 5.5 Flash Base บน Hugging Face
- ยังไม่ระบุ ปล่อยรุ่นที่ผ่าน post-training
คำถามที่พบบ่อยเกี่ยวกับ ERNIE 5.5 Flash Base
ERNIE 5.5 Flash Base คืออะไร
โมเดลภาษาฐานแบบ MoE ของ Baidu ขนาด 280B ใช้งาน 14B ต่อโทเคน เปิดให้ดาวน์โหลดน้ำหนัก
ดาวน์โหลดได้ที่ไหน
Hugging Face ที่ baidu/ERNIE-5.5-Flash-Base (FP8) และ baidu/ERNIE-5.5-Flash-Base-BF16
ใช้แชตแบบผู้ช่วย AI ได้เลยไหม
ไม่เหมาะ เพราะเป็นโมเดลฐานที่ยังไม่ผ่าน post-training
รองรับบริบทยาวแค่ไหน
ฝึกที่ 128K และปรับแต่งหรือใช้งานได้ถึง 1 ล้านโทเคน
รันด้วยเครื่องมืออะไรได้บ้าง
SGLang, vLLM และ Transformers ส่วนการฝึกต่อมีตัวอย่างบน NVIDIA NeMo Megatron-Bridge
ความคิดเห็น 0
ยังไม่มีความคิดเห็นเป็นคนแรกที่แสดงความคิดเห็นในบทความนี้